本文提出了一个使用传统DAS和深度强化学习融合的自动驾驶框架。该框架在DAS功能(例如车道变换,巡航控制和车道保持等)下,以最大限度地提高平均速度和最少车道变化为规则,来确定超车次数。可行驶空间
2018-06-14 09:41:09 9663
本文来自爱奇艺资深工程师王亚楠在LiveVideoStackCon2018热身分享,由LiveVideoStack整理而成。在分享中,王亚楠介绍了自动码率调节算法的实现过程与评价标准,以及基于强化学习的自动码率调节算法的技术架构与实现要点。
2018-08-02 17:51:417211 
使用Isaac Gym来强化学习mycobot抓取任务
2023-04-11 14:57:129694 
什么是深度强化学习? 众所周知,人类擅长解决各种挑战性的问题,从低级的运动控制(如:步行、跑步、打网球)到高级的认知任务。
2023-07-01 10:29:502122 
Lab 是一个适用于机器人学习的开源模块化框架,其模块化高保真仿真适用于各种训练环境,Isaac Lab 同时支持模仿学习(模仿人类)和强化学习(在尝试和错误中进行学习),为所有机器人具身提供了灵活的训练方法。它能够为各种训练场景提供用户友好的环境,帮助增加或更新机器人技能。
2025-07-14 15:29:112039 
Facebook近日推出ReAgent强化学习(reinforcement learning)工具包,首次通过收集离线反馈(offline feedback)来实现策略评估(policy evaluation)。
2019-10-19 09:38:411956 强化学习的另一种策略(二)
2019-04-03 12:10:44
`转一篇好资料机器学习算法可以分为三大类:监督学习、无监督学习和强化学习。监督学习可用于一个特定的数据集(训练集)具有某一属性(标签),但是其他数据没有标签或者需要预测标签的情况。无监督学习可用
2017-04-18 18:28:36
内容2:课程一: Tensorflow入门到熟练:课程二:图像分类:课程三:物体检测:课程四:人脸识别:课程五:算法实现:1、卷积神经网络CNN2、循环神经网络RNN3、强化学习DRL4、对抗性生成
2021-01-09 17:01:54
时间安排大纲具体内容实操案例三天关键点1.强化学习的发展历程2.马尔可夫决策过程3.动态规划4.无模型预测学习5.无模型控制学习6.价值函数逼近7.策略梯度方法8.深度强化学习-DQN算法系列9.
2022-04-21 14:57:39
内容2:课程一: TensoRFlow入门到熟练:课程二:图像分类:课程三:物体检测:课程四:人脸识别:课程五:算法实现:1、卷积神经网络CNN2、循环神经网络RNN3、强化学习DRL4、对抗性生成
2021-01-10 13:42:26
针对强化学习在连续状态连续动作空间中的维度灾难问题,利用BP神经网络算法作为值函数逼近策略,设计了自动驾驶仪。并引入动作池机制,有效避免飞行仿真中危险动作的发生。首先
2013-06-25 16:27:22 27
强化学习在RoboCup带球任务中的应用_刘飞
2017-03-14 08:00:000 请订阅2016年《程序员》 尽管监督式和非监督式学习的深度模型已经广泛被技术社区所采用,深度强化学习仍旧显得有些神秘。这篇文章将试图揭秘
2017-10-09 18:28:430 与监督机器学习不同,在强化学习中,研究人员通过让一个代理与环境交互来训练模型。当代理的行为产生期望的结果时,它得到正反馈。例如,代理人获得一个点数或赢得一场比赛的奖励。简单地说,研究人员加强了代理人的良好行为。
2018-07-13 09:33:0025158 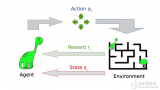
深度强化学习DRL自提出以来, 已在理论和应用方面均取得了显著的成果。尤其是谷歌DeepMind团队基于深度强化学习DRL研发的AlphaGo,将深度强化学习DRL成推上新的热点和高度,成为人工智能历史上一个新的里程碑。因此,深度强化学习DRL非常值得研究。
2018-06-29 18:36:0028671 萨顿在专访中(再次)科普了强化学习、深度强化学习,并谈到了这项技术的潜力,以及接下来的发展方向:预测学习
2017-12-27 09:07:1511877 策略可获得的最大回报;其次,利用分层强化学习方法的无环境模型学习以及局部更新能力将策略更新过程限制在规模较小的局部空间或维度较低的高层空间上,提高学习算法的性能;最后,针对出租车问题在栅格环境中对所提算法进行了仿真实验
2017-12-27 14:32:020 本文提出了一种LCS和LS-SVM相结合的多机器人强化学习方法,LS-SVM获得的最优学习策略作为LCS的初始规则集。LCS通过与环境的交互,能更快发现指导多机器人强化学习的规则,为强化学习系统
2018-01-09 14:43:490 问题,对半监督学习中的协同训练算法进行改进,提出了一种基于多学习器协同训练模型的人体行为识别方法.这是一种基于半监督学习框架的识别算法,该方法首先通过基于Q统计量的学习器差异性度量选择算法来挑取出协同训练中基学习
2018-01-21 10:41:091 在风储配置给定前提下,研究风电与储能系统如何有机合作的问题。核心在于风电与储能组成混合系统参与电力交易,通过合作提升其市场竞争的能力。针对现有研究的不足,在具有过程化样本的前提下,引入强化学习算法
2018-01-27 10:20:502 在本篇论文中,研究人员使用流行的异步进化算法(asynchronous evolutionary algorithm)的正则化版本,并将其与非正则化的形式以及强化学习方法进行比较。
2018-02-09 14:47:414352 
传统上,强化学习在人工智能领域占据着一个合适的地位。但强化学习在过去几年已开始在很多人工智能计划中发挥更大的作用。
2018-03-03 14:16:564677 为了弥补IEEE 802.15.4协议原有区分服务机制的不足,提出了一种基于BCS(backoff counter scheme)与强化学习的区分服务策略。从终端节点出发,在原优先级区分服务策略
2018-03-09 16:02:070 Q-learning和SARSA是两种最常见的不理解环境强化学习算法,这两者的探索原理不同,但是开发原理是相似的。Q-learning是一种离线学习算法,智能体需要从另一项方案中学习到行为a*的价值
2018-04-15 10:32:2214964 强化学习是智能系统从环境到行为映射的学习,以使奖励信号(强化信号)函数值最大,强化学习不同于连接主义学习中的监督学习,主要表现在教师信号上,强化学习中由环境提供的强化信号是对产生动作的好坏作一种评价
2018-05-30 06:53:001741 当我们使用虚拟的计算机屏幕和随机选择的图像来模拟一个非常相似的测试时,我们发现,我们的“元强化学习智能体”(meta-RL agent)似乎是以类似于Harlow实验中的动物的方式在学习,甚至在被显示以前从未见过的全新图像时也是如此。
2018-05-16 09:03:395238 
McAleer和他的团队称这个过程为“一种新型的强化学习算法,能够教导算法如何在没有人类协助的情况下解开魔方。” 他们声称,这种学习算法可以在30步内解开100%的随机打乱魔方 - 这和人类的表现不相上下或优于人类的表现。
2018-06-22 16:49:394426 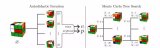
Q Learning算法是由Watkins于1989年在其博士论文中提出,是强化学习发展的里程碑,也是目前应用最为广泛的强化学习算法。
2018-07-05 14:10:004098 自动驾驶汽车首先是人工智能问题,而强化学习是机器学习的一个重要分支,是多学科多领域交叉的一个产物。今天人工智能头条给大家介绍强化学习在自动驾驶的一个应用案例,无需3D地图也无需规则,让汽车从零开始在二十分钟内学会自动驾驶。
2018-07-10 09:00:295636 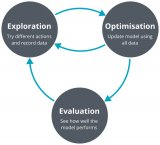
前段时间,OpenAI的游戏机器人在Dota2的比赛中赢了人类的5人小组,取得了团队胜利,是强化学习攻克的又一游戏里程碑。
2018-07-13 08:56:015357 
强化学习是人工智能基本的子领域之一,在强化学习的框架中,智能体通过与环境互动,来学习采取何种动作能使其在给定环境中的长期奖励最大化,就像在上述的棋盘游戏寓言中,你通过与棋盘的互动来学习。
2018-07-15 10:56:3718470 
这些具有一定难度的任务 OpenAI 自己也在研究,他们认为这是深度强化学习发展到新时代之后可以作为新标杆的算法测试任务,而且也欢迎其它机构与学校的研究人员一同研究这些任务,把深度强化学习的表现推上新的台阶。
2018-08-03 14:27:265370 结合 DL 与 RL 的深度强化学习(Deep Reinforcement Learning, DRL)迅速成为人工智能界的焦点。
2018-08-09 10:12:436869 强化学习作为一种常用的训练智能体的方法,能够完成很多复杂的任务。在强化学习中,智能体的策略是通过将奖励函数最大化训练的。奖励在智能体之外,各个环境中的奖励各不相同。深度学习的成功大多是有密集并且有效的奖励函数,例如电子游戏中不断增加的“分数”。
2018-08-18 11:38:574166 而这时,强化学习会在没有任何标签的情况下,通过先尝试做出一些行为得到一个结果,通过这个结果是对还是错的反馈,调整之前的行为,就这样不断的调整,算法能够学习到在什么样的情况下选择什么样的行为可以得到最好的结果。
2018-08-21 09:18:2521886 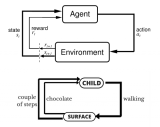
强化学习(RL)研究在过去几年取得了许多重大进展。强化学习的进步使得 AI 智能体能够在一些游戏上超过人类,值得关注的例子包括 DeepMind 攻破 Atari 游戏的 DQN,在围棋中获得瞩目的 AlphaGo 和 AlphaGo Zero,以及在 Dota2 对战人类职业玩家的Open AI Five。
2018-08-31 09:20:494367 对于新的研究人员来说,能够根据既定方法快速对其想法进行基准测试非常重要。因此,我们为 Arcade 学习环境支持的 60 个游戏提供四个智能体的完整培训数据,可用作 Python pickle 文件
2018-08-31 10:55:305376 强化学习是一种非常重要 AI 技术,它能使用奖励(或惩罚)来驱动智能体(agents)朝着特定目标前进,比如它训练的 AI 系统 AlphaGo 击败了顶尖围棋选手,它也是 DeepMind 的深度
2018-09-03 14:06:303344 强化学习是一种训练主体最大化奖励的学习机制,对于目标条件下的强化学习来说可以将奖励函数设为当前状态与目标状态之间距离的反比函数,那么最大化奖励就对应着最小化与目标函数的距离。
2018-09-24 10:11:007591 按照以往的做法,如果研究人员要用强化学习算法对奖励进行剪枝,以此克服奖励范围各不相同的问题,他们首先会把大的奖励设为+1,小的奖励为-1,然后对预期奖励做归一化处理。虽然这种做法易于学习,但它也改变了智能体的目标。
2018-09-16 09:32:036329 Silver的演讲中提出的强化学习10大要点涵盖涉及算法评估、状态控制、建模函数等方面的心得和建议,非常值得开发者和机器学习爱好者参考学习。一起看看他是怎么说的吧!
2018-09-17 08:41:193694 之前接触的强化学习算法都是单个智能体的强化学习算法,但是也有很多重要的应用场景牵涉到多个智能体之间的交互。
2018-11-02 16:18:1522830 11月1日,Facebook开源了Horizon,一个由Facebook的AI研究人员、推荐系统专家和工程师共同搭建的强化学习平台,其框架的构建工作开始于两年半前,在过去一年中一直被Facebook内部使用。
2018-11-05 09:34:171140 本文作者通过简单的方式构建了强化学习模型来训练无人车算法,可以为初学者提供快速入门的经验。
2018-11-12 14:47:395434 OpenAI 近期发布了一个新的训练环境 CoinRun,它提供了一个度量智能体将其学习经验活学活用到新情况的能力指标,而且还可以解决一项长期存在于强化学习中的疑难问题——即使是广受赞誉的强化算法在训练过程中也总是没有运用监督学习的技术。
2019-01-01 09:22:003047 
强化学习(RL)能通过奖励或惩罚使智能体实现目标,并将它们学习到的经验转移到新环境中。
2018-12-24 09:29:563716 在一些情况下,我们会用策略函数(policy, 总得分,也就是搭建的网络在测试集上的精度(accuracy),通过强化学习(Reinforcement Learning)这种通用黑盒算法来优化。然而,因为强化学习本身具有数据利用率低的特点,这个优化的过程往往需要大量的计算资源。
2019-01-28 09:54:225819 Google AI 与 DeepMind 合作推出深度规划网络 (PlaNet),这是一个纯粹基于模型的智能体,能从图像输入中学习世界模型,完成多项规划任务,数据效率平均提升50倍,强化学习又一突破。
2019-02-17 09:30:283943 
在传统的多智体学习过程当中,有研究者在对其他智能体建模 (也即“对手建模”, opponent modeling) 时使用了递归推理,但由于算法复杂和计算力所限,目前还尚未有人在多智体深度强化学习 (Multi-Agent Deep Reinforcement Learning) 的对手建模中使用递归推理。
2019-03-05 08:52:435713 近日,Reddit一位网友根据近期OpenAI Five、AlphaStar的表现,提出“深度强化学习是否已经到达尽头”的问题。
2019-05-10 16:34:592987 近年来,深度强化学习(Deep reinforcement learning)方法在人工智能方面取得了瞩目的成就
2019-06-03 14:36:053355 近几年来,强化学习在任务导向型对话系统中得到了广泛的应用,对话系统通常被统计建模成为一个 马尔科夫决策过程(Markov Decision Process)模型,通过随机优化的方法来学习对话策略。
2019-08-06 14:16:292402 强化学习非常适合实现自主决策,相比之下监督学习与无监督学习技术则无法独立完成此项工作。
2019-12-10 14:34:571667 本文档的主要内容详细介绍的是深度强化学习的笔记资料免费下载。
2020-03-10 08:00:000 强化学习(RL)是现代人工智能领域中最热门的研究主题之一,其普及度还在不断增长。 让我们看一下开始学习RL需要了解的5件事。
2020-05-04 18:14:004155 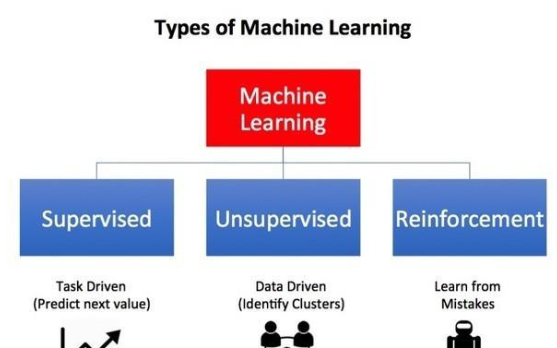
深度学习DL是机器学习中一种基于对数据进行表征学习的方法。深度学习DL有监督和非监督之分,都已经得到广泛的研究和应用。强化学习RL是通过对未知环境一边探索一边建立环境模型以及学习得到一个最优策略。强化学习是机器学习中一种快速、高效且不可替代的学习算法。
2020-05-16 09:20:403977 深度学习DL是机器学习中一种基于对数据进行表征学习的方法。深度学习DL有监督和非监督之分,都已经得到广泛的研究和应用。强化学习RL是通过对未知环境一边探索一边建立环境模型以及学习得到一个最优策略。强化学习是机器学习中一种快速、高效且不可替代的学习算法。
2020-06-13 11:39:407089 近期,有不少报道强化学习算法在 GO、Dota 2 和 Starcraft 2 等一系列游戏中打败了专业玩家的新闻。强化学习是一种机器学习类型,能够在电子游戏、机器人、自动驾驶等复杂应用中运用人工智能。
2020-07-27 08:50:151212 Viet Nguyen就是其中一个。这位来自德国的程序员表示自己只玩到了第9个关卡。因此,他决定利用强化学习AI算法来帮他完成未通关的遗憾。
2020-07-29 09:30:163424 强化学习属于机器学习中的一个子集,它使代理能够理解在特定环境中执行特定操作的相应结果。目前,相当一部分机器人就在使用强化学习掌握种种新能力。
2020-11-06 15:33:492130 深度强化学习是深度学习与强化学习相结合的产物,它集成了深度学习在视觉等感知问题上强大的理解能力,以及强化学习的决策能力,实现了...
2020-12-10 18:32:501078 RLax(发音为“ relax”)是建立在JAX之上的库,它公开了用于实施强化学习智能体的有用构建块。。报道:深度强化学习实验室作者:DeepRL ...
2020-12-10 18:43:231333 本文主要介绍深度强化学习在任务型对话上的应用,两者的结合点主要是将深度强化学习应用于任务型对话的策略学习上来源:腾讯技术工程微信号
2020-12-10 19:02:451545 回顾深度学习框架的演变,我们可以清楚地看到深度学习框架和深度学习算法之间的紧密耦合关系。这种相互依赖的良性循环推动了深度学习框架和工具的快速发展。
2021-01-21 13:46:553613 基准算法,其仅利用城市间的距离等静态结构信息来构造初始解,解构造方法2~解构造方法4则尝试利用搜索过程中积累的历史数据,通过强化学习挖掘有用信息,用于引导解的构造过程。在25个国际公开算例上的测试结果表明,基于历史信息的
2021-03-17 11:42:3716 强化学习( Reinforcement learning,RL)作为机器学习领域中与监督学习、无监督学习并列的第三种学习范式,通过与环境进行交互来学习,最终将累积收益最大化。常用的强化学习算法分为
2021-04-08 11:41:5811 深度强化学习(DRL)作为机器学习的重要分攴,在 Alphago击败人类后受到了广泛关注。DRL以种试错机制与环境进行交互,并通过最大化累积奖赏最终得到最优策略。强化学习可分为无模型强化学习和模型化
2021-04-12 11:01:529 Control of Bipedal Robots)为题,已被机器人国际学术顶会 ICRA 收录。 通过强化学习,它能自己走路,并能进行自我恢复。在现实世界中,通过反复试
2021-04-13 09:35:093022 
强化学习是人工智能领域中的一个研究热点。在求解强化学习问题时,传统的最小二乘法作为一类特殊的函数逼近学习方法,具有收敛速度快、充分利用样本数据的优势。通过对最小二乘时序差分算法
2021-04-23 15:03:035 利用深度强化学习技术实现路口信号控制是智能交通领域的硏究热点。现有硏究大多利用强化学习来全面刻画交通状态以及设计有效强化学习算法以解决信号配时问题,但这些研究往往忽略了信号灯状态对动作选择的影响以及
2021-04-23 15:30:5321 在移动雾计算中,雾节点与移动终端用户之间的通信容易受到伪装攻击,从而带来通信和数据传输的安全问题。基于移动雾环境下的物理层密钥生成策略,提出一种基于强化学习的伪装攻击检测算法。构建移动雾计算中的伪装
2021-05-11 11:48:395 符号构建标注词典,通过依存句法分析融合语义特征,并以长短期记忆网络为策略网络,利用循环记忆完善部分观测信息。在此基础上,引入强化学习框架,将目标词性作为环境反馈,通过特征学习不断逼近目标真实值。实验结果表明
2021-05-14 11:29:3514 压边力控制策略的学习优化。基于深度强化学习的压边力优化算法,利用深度神经网络处理巨大的状态空间,避免了系统动力学的拟合,并且使用一种新的网络结构来构建策略网络,将压边力策略划分为全局与局部两部分,提高了压边
2021-05-27 10:32:390 一种新型的多智能体深度强化学习算法
2021-06-23 10:42:4736 基于深度强化学习的无人机控制律设计方法
2021-06-23 14:59:1046 基于强化学习的虚拟场景角色乒乓球训练
2021-06-27 11:34:3362 使用Matlab进行强化学习电子版资源下载
2021-07-16 11:17:090 多Agent 深度强化学习综述 来源:《自动化学报》,作者梁星星等 摘 要 近年来,深度强化学习(Deep reinforcement learning,DRL) 在诸多复杂序贯决策问题中取得巨大
2022-01-18 10:08:012300 
本文主要内容是如何用Oenflow去复现强化学习玩 Flappy Bird 小游戏这篇论文的算法关键部分,还有记录复现过程中一些踩过的坑。
2022-01-26 18:19:342 定标记训练数据的情况下获得正确的输出 无监督学习(UL):关注在没有预先存在的标签的情况下发现数据中的模式 强化学习(RL) : 关注智能体在环境中如何采取行动以最大化累积奖励 通俗地说,强化学习类似于婴儿学习和发现世界,如果有奖励(正强化),婴儿可能会执行一个行
2022-12-20 14:00:021683 电子发烧友网站提供《ESP32上的深度强化学习.zip》资料免费下载
2022-12-27 10:31:451 作者:Siddhartha Pramanik 来源:DeepHub IMBA 目前流行的强化学习算法包括 Q-learning、SARSA、DDPG、A2C、PPO、DQN 和 TRPO。这些算法
2023-02-03 20:15:061744 一套泛化能力强的决策规划机制是智能驾驶目前面临的难点之一。强化学习是一种从经验中总结的学习方式,并从长远的角度出发,寻找解决问题的最优方案。近些年来,强化学习在人工智能领域取得了重大突破,因而成为了解决智能驾驶决策规划问题的一种新的思路。
2023-02-08 14:05:162890 强化学习(RL)是人工智能的一个子领域,专注于决策过程。与其他形式的机器学习相比,强化学习模型通过与环境交互并以奖励或惩罚的形式接收反馈来学习。
2023-06-09 09:23:23930 大模型时代,模型压缩和加速显得尤为重要。传统监督学习可通过稀疏神经网络实现模型压缩和加速,那么同样需要大量计算开销的强化学习任务可以基于稀疏网络进行训练吗?本文提出了一种强化学习专用稀疏训练框架
2023-06-11 21:40:021325 
前言 DeepMind 最近在 Nature 发表了一篇论文 AlphaDev[2, 3],一个利用强化学习来探索更优排序算法的AI系统。 AlphaDev 系统直接从 CPU 汇编指令的层面入手去
2023-06-19 10:49:271378 
的情况下获得正确的输出无监督学习(UL):关注在没有预先存在的标签的情况下发现数据中的模式强化学习(RL):关注智能体在环境中如何采取行动以最大化累积奖励通俗地说,强
2023-01-05 14:54:051714 
作者:SiddharthaPramanik来源:DeepHubIMBA目前流行的强化学习算法包括Q-learning、SARSA、DDPG、A2C、PPO、DQN和TRPO。这些算法已被用于在游戏
2023-02-06 15:06:384620 电子发烧友网站提供《人工智能强化学习开源分享.zip》资料免费下载
2023-06-20 09:27:281 摘要:基于强化学习的目标检测算法在检测过程中通常采用预定义搜索行为,其产生的候选区域形状和尺寸变化单一,导致目标检测精确度较低。为此,在基于深度强化学习的视觉目标检测算法基础上,提出联合回归与深度
2023-07-19 14:35:020 深度学习算法库框架学习 深度学习是一种非常强大的机器学习方法,它可以用于许多不同的应用程序,例如计算机视觉、语言处理和自然语言处理。然而,实现深度学习技术需要使用一些算法库框架。在本文中,我们将探讨
2023-08-17 16:11:071407 深度学习框架和深度学习算法教程 深度学习是机器学习领域中的一个重要分支,多年来深度学习一直在各个领域的应用中发挥着极其重要的作用,成为了人工智能技术的重要组成部分。许多深度学习算法和框架提供了
2023-08-17 16:11:261829 讯维模拟矩阵在深度强化学习智能控制系统中的应用主要是通过构建一个包含多种环境信息和动作空间的模拟矩阵,来模拟和预测深度强化学习智能控制系统在不同环境下的表现和效果,从而优化控制策略和提高系统的性能
2023-09-04 14:26:361156 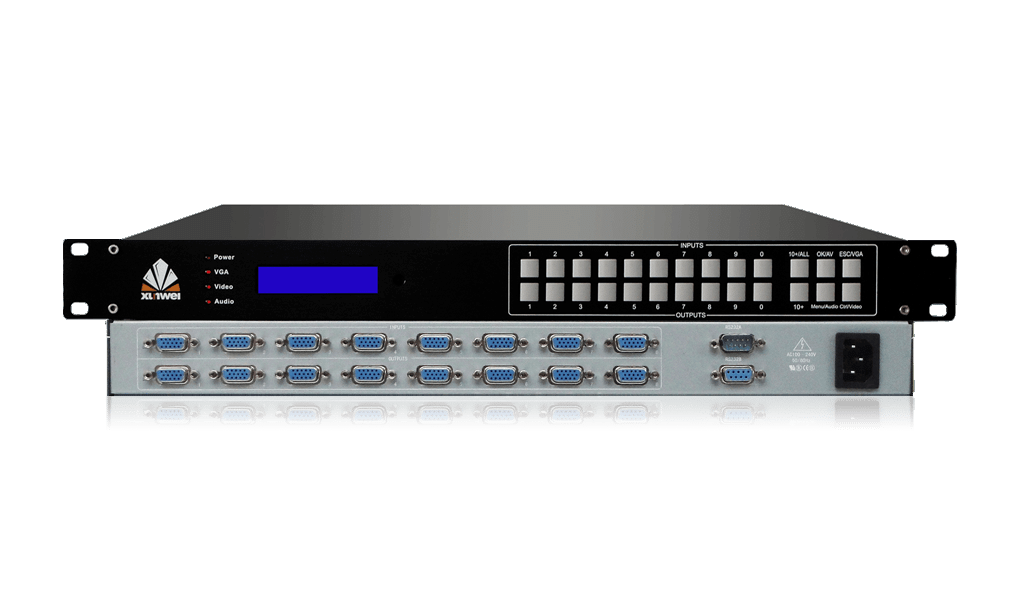
扩散模型(diffusion model)在 CV 领域甚至 NLP 领域都已经有了令人印象深刻的表现。最近的一些工作开始将 diffusion model 用于强化学习(RL)中来解决序列决策问题
2023-10-02 10:45:021713 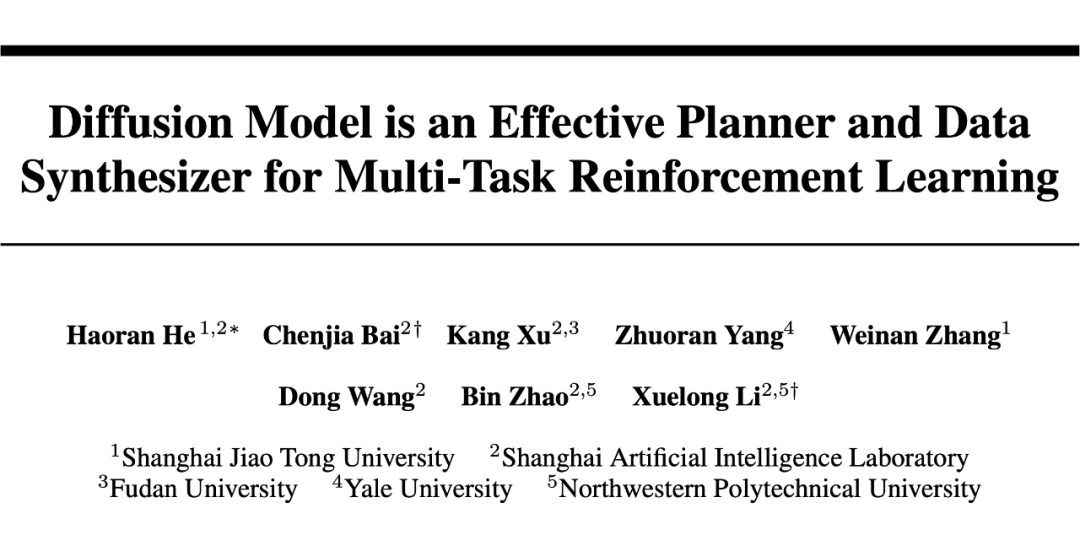
强化学习是机器学习的方式之一,它与监督学习、无监督学习并列,是三种机器学习训练方法之一。 在围棋上击败世界第一李世石的 AlphaGo、在《星际争霸2》中以 10:1 击败了人类顶级职业玩家
2023-10-30 11:36:405374 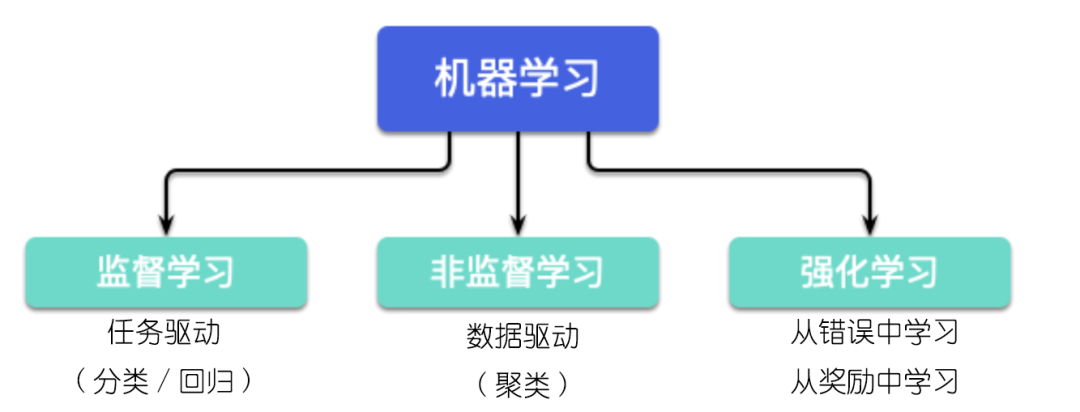
更快更好地学习。我们的想法是找到最优数量的特征和最有意义的特征。在本文中,我们将介绍并实现一种新的通过强化学习策略的特征选择。我们先讨论强化学习,尤其是马尔可夫决策
2024-06-05 08:27:46971 的计算图和自动微分功能,非常适合实现复杂的强化学习算法。 1. 环境(Environment) 在强化学习中,环境是一个抽象的概念,它定义了智能体(agent)可以执行的动作(actions)、观察到
2024-11-05 17:34:281519 本来转自:DeepHubIMBA本文系统讲解从基本强化学习方法到高级技术(如PPO、A3C、PlaNet等)的实现原理与编码过程,旨在通过理论结合代码的方式,构建对强化学习算法的全面理解。为确保内容
2025-04-23 13:22:041417 下,就是一个智能体在环境里行动,它能观察到环境的一些信息,并做出一个动作,然后环境会给出一个反馈(奖励或惩罚),智能体的目标是把长期得到的奖励累积到最大。和监督学习不同,强化学习没有一一对应的“正确答案”给它看,而是靠与环境交互、自我探索来发现
2025-10-23 09:00:37479 
 电子发烧友App








 工商网监
评论